avatar😭
WALKERKILLER新月潮汐摄动流形

快逃,别回头,这里不是伊甸

Time to leave, My Eden is burning.
广告位招租
我已经活了
20年10月2天23时11分25秒

概率论与数理统计知识点

随机变量及其分布 ​

随机变量及其分布 ​

分布函数: def:F(x)=P(X≤x)def: F(x) = P(X \le x)

  • 性质: 非负性、单调性、规范性、连续性(右连续)

离散分布 ​

  1. 二项分布: X∼B(n,p)X \sim B(n, p)
    • P(X=k)=Cnkpk(1−p)n−k(k=0,1,…,n)P(X=k) = C_n^k p^k (1-p)^{n-k} \quad (k=0, 1, \dots, n)
    • EX=npEX = np, VarX=np(1−p)VarX = np(1-p)
  2. 几何分布: X∼Ge(p)X \sim Ge(p)
    • P(X=k)=(1−p)k−1p(k=1,2,… )P(X=k) = (1-p)^{k-1}p \quad (k=1, 2, \dots)
    • EX=1pEX = \frac{1}{p}, VarX=1−pp2VarX = \frac{1-p}{p^2}
  3. 泊松分布: X∼P(λ)X \sim P(\lambda)
    • P(X=k)=λke−λk!(k=0,1,2,… )P(X=k) = \frac{\lambda^k e^{-\lambda}}{k!} \quad (k=0, 1, 2, \dots)
    • EX=λEX = \lambda, VarX=λVarX = \lambda
    • 泊松定理: X∼B(n,p)→近似np→λ,n很大X∼P(np)X \sim B(n, p) \xrightarrow[\text{近似}]{np \to \lambda, n \text{很大}} X \sim P(np)

连续分布 ​

  1. 均匀分布: X∼U(a,b)X \sim U(a, b)

    • f(x)={1b−aa<x<b0余f(x) = \begin{cases} \frac{1}{b-a} & a < x < b \\ 0 & \text{余} \end{cases}
    • EX=a+b2EX = \frac{a+b}{2}
    • VarX=(b−a)212VarX = \frac{(b-a)^2}{12}
    • F(x)={0x<ax−ab−aa≤x<b1x≥bF(x) = \begin{cases} 0 & x < a \\ \frac{x-a}{b-a} & a \le x < b \\ 1 & x \ge b \end{cases}
  2. 指数分布: X∼E(λ)X \sim E(\lambda)

    • f(x)={λe−λxx>00余f(x) = \begin{cases} \lambda e^{-\lambda x} & x > 0 \\ 0 & \text{余} \end{cases}
    • EX=1λEX = \frac{1}{\lambda}
    • VarX=1λ2VarX = \frac{1}{\lambda^2}
    • F(x)={1−e−λxx>00x≤0F(x) = \begin{cases} 1 - e^{-\lambda x} & x > 0 \\ 0 & x \le 0 \end{cases}
    • tips:指数分布具有无记忆性,即 P(X>s+t∣X>s)=P(X>t)P(X > s+t | X > s) = P(X > t)
    • ① 问“小于” (X≤xX \le x):即“在 xx 时间前坏掉/发生”的概率:

      F(x)=P(X≤x)=1−e−λxF(x) = P(X \le x) = 1 - e^{-\lambda x}

    • ② 问“大于” (X>xX > x):即“活过 xx 时间 / 至少能用 xx 小时”的概率(这叫生存函数):

      P(X>x)=e−λxP(X > x) = e^{-\lambda x}

  3. 正态分布: X∼N(μ,σ2)X \sim N(\mu, \sigma^2)

    • f(x)=12πσe−(x−μ)22σ2−∞<x<+∞f(x) = \frac{1}{\sqrt{2\pi}\sigma} e^{-\frac{(x-\mu)^2}{2\sigma^2}} \quad -\infty < x < +\infty
    • EX=μEX = \mu, VarX=σ2VarX = \sigma^2
    • 标准正态分布: X∼N(0,1)X \sim N(0, 1), φ(x)=12πe−x22\varphi(x) = \frac{1}{\sqrt{2\pi}} e^{-\frac{x^2}{2}}
    • F(x)=P(X≤x)=P(X−μσ≤x−μσ)=Φ(x−μσ)F(x) = P(X \le x) = P(\frac{X-\mu}{\sigma} \le \frac{x-\mu}{\sigma}) = \Phi(\frac{x-\mu}{\sigma})
    • 性质: Φ(−a)=1−Φ(a)\Phi(-a) = 1 - \Phi(a), Φ(0)=12\Phi(0) = \frac{1}{2}, P(∣X∣≤a)=2Φ(a)−1P(|X| \le a) = 2\Phi(a) - 1
    • if f(x)=Aeax+bx+cf(x) = Ae^{ax+bx+c} (x∈(a,b)(or)x∈(−∞,+∞))(x \in (a, b) (or) x \in (-\infty, +\infty)) 则为正态

随机变量函数的分布 ​

  • 命题: FY(y)=P(Y≤y)=P(g(X)≤y)=∫g(x)≤yfX(x)dxF_Y(y) = P(Y \le y) = P(g(X) \le y) = \int_{g(x)\le y} f_X(x)dx
  • 定理: XX 的密度函数 fX(x)f_X(x) 在 (a,b)(a, b) 之间严格单调,则 Y=f(X)Y=f(X) 服从 (a,b)(a, b) 上的分布:
    • 0≤y≤10 \le y \le 1: fY(y)=P(∣y∣)=P(F−1(y))∣(F−1)′(y)∣f_Y(y) = P(|y|) = P(F^{-1}(y)) |(F^{-1})'(y)|
    • =P∣X≤F−1(y)∣=F(F−1(y))=y= P|X \le F^{-1}(y)| = F(F^{-1}(y)) = y (均匀分布)
    • 一般地:fY(y)=fX[h(y)]⋅∣h′(y)∣f_Y(y) = f_X[h(y)] \cdot |h'(y)| (其中 x=h(y)x=h(y) 是反函数)

多维随机变量及分布 ​

F(x,y)=P(X≤x,Y≤y)F(x, y) = P(X \le x, Y \le y)

  • 性质:
    1. F(+∞,+∞)=1F(+\infty, +\infty) = 1, F(−∞,+∞)=0F(-\infty, +\infty) = 0, F(+∞,−∞)=0F(+\infty, -\infty) = 0
    2. 非负性、规范性、单调不减性、右连续性
    3. P(x1<X≤x2,y1<Y≤y2)=F(x2,y2)−F(x1,y2)−F(x2,y1)+F(x1,y1)P(x_1 < X \le x_2, y_1 < Y \le y_2) = F(x_2, y_2) - F(x_1, y_2) - F(x_2, y_1) + F(x_1, y_1)

二维连续 ​

  • F(x,y)=∫−∞x∫−∞yf(u,v)dudvF(x, y) = \int_{-\infty}^{x} \int_{-\infty}^{y} f(u, v) du dv
  • P((X,Y)∈G)=∬Gf(x,y)dxdyP((X,Y) \in G) = \iint_G f(x, y) dx dy

边缘概率密度 ​

  • fX(x)=∫−∞+∞f(x,y)dyf_X(x) = \int_{-\infty}^{+\infty} f(x, y) dy
  • fY(y)=∫−∞+∞f(x,y)dxf_Y(y) = \int_{-\infty}^{+\infty} f(x, y) dx

条件概率密度 ​

  • fX∣Y(x∣y)=f(x,y)fY(y)f_{X|Y}(x|y) = \frac{f(x, y)}{f_Y(y)} 为在 Y=yY=y 条件下 XX 的概率密度(要写出来)

独立性 ​

f(x,y)=fX(x)⋅fY(y)f(x, y) = f_X(x) \cdot f_Y(y)

二维均匀分布 ​

A=SDA = S_D, f(x,y)={1SD(x,y)∈D0余f(x, y) = \begin{cases} \frac{1}{S_D} & (x, y) \in D \\ 0 & \text{余} \end{cases}

性质:

  1. (X,Y)(X, Y) 在 D={(x,y)∣a≤x≤b,c≤y≤d}D = \{ (x, y) | a \le x \le b, c \le y \le d \} 上服从二维均匀分布   ⟺  X∼U(a,b),Y∼U(c,d)\iff X \sim U(a, b), Y \sim U(c, d)
  2. (X,Y)∈G,P((X,Y)∈G)=SGSD(X, Y) \in G, P((X, Y) \in G) = \frac{S_G}{S_D}
  3. But!!! (X,Y)(X, Y) 服从二维均匀分布 ⇏X,Y\nRightarrow X, Y 服从一维均匀分布 (反之亦然)

二维正态、极值、可加性与数字特征 ​

二维正态分布: (X,Y)∼N(μ1,μ2;σ12,σ22;ρ)(X, Y) \sim N(\mu_1, \mu_2; \sigma_1^2, \sigma_2^2; \rho)性质:

  1. 边缘分布是正态分布 X∼N(μ1,σ12)X \sim N(\mu_1, \sigma_1^2), Y∼N(μ2,σ22)Y \sim N(\mu_2, \sigma_2^2)
  2. XX 与 YY 相互独立之充要条件 ρ=0\rho = 0
  3. aX+bY∼N(aμ1+bμ2,a2σ12+b2σ22+2abρσ1σ2)aX + bY \sim N(a\mu_1 + b\mu_2, a^2\sigma_1^2 + b^2\sigma_2^2 + 2ab\rho\sigma_1\sigma_2)
  4. 条件分布正态分布
  5. (aX+b,cY+d)(aX+b, cY+d) 也服从二维正态。∣abcd∣≠0|\begin{smallmatrix} a & b \\ c & d \end{smallmatrix}| \ne 0

计算: X1∼N(μ1,σ12)X_1 \sim N(\mu_1, \sigma_1^2) 且相互独立 ∑aiXi∼N(∑aiμi,∑ai2σi2)\sum a_i X_i \sim N(\sum a_i \mu_i, \sum a_i^2 \sigma_i^2)

二维随机变量函数分布 ​

FZ(z)=P(Z≤z)=P(X+Y≤z)=∬x+y≤zf(x,y)dxdyF_Z(z) = P(Z \le z) = P(X+Y \le z) = \iint_{x+y \le z} f(x, y) dx dy

两种方法,一种分布函数法,普遍适用,如果相互独立,可以卷积

如果 XX 和 YY 独立,我们可以跳过二重积分,直接套单重积分公式。

卷积公式:

fZ(z)=∫−∞+∞fX(x)⋅fY(z−x) dxf_Z(z) = \int_{-\infty}^{+\infty} f_X(x) \cdot f_Y(z-x) \, dx

两个坑

  1. fY(z−x)f_Y(z-x) 是啥? 就是把 fY(y)f_Y(y) 里的 yy 替换成 z−xz-x。
  2. 积分限怎么定?
    • 公式写的是 −∞-\infty 到 +∞+\infty,但实际上要看 fX(x)f_X(x) 和 fY(z−x)f_Y(z-x) 哪里不为 0
    • 我们要找这两个函数“非零区域”的交集

最大值最小值分布 ​

X1…XnX_1 \dots X_n 相互独立

  • U=max⁡{X1…Xn}U = \max\{X_1 \dots X_n\}
    • Fmax(z)=FX1(z)FX2(z)…FXn(z)F_{max}(z) = F_{X_1}(z) F_{X_2}(z) \dots F_{X_n}(z)
    • if iid Fmax(z)=[F(z)]nF_{max}(z) = [F(z)]^n
  • V=min⁡{X1…Xn}V = \min\{X_1 \dots X_n\}
    • Fmin(z)=1−[1−FX1(z)][1−FX2(z)]…[1−FXn(z)]F_{min}(z) = 1 - [1-F_{X_1}(z)][1-F_{X_2}(z)]\dots[1-F_{X_n}(z)]
    • if iid Fmin(z)=1−[1−F(z)]nF_{min}(z) = 1 - [1-F(z)]^n

具有可加性的分布 ​

  • Xi∼B(ni,p)⇒X1+X2+⋯+Xn∼B(n1+⋯+nk,p)X_i \sim B(n_i, p) \Rightarrow X_1 + X_2 + \dots + X_n \sim B(n_1+\dots+n_k, p)
  • (独立同分布)
  • Xi∼P(λi)⇒X1+X2+⋯+Xk∼P(λ1+⋯+λk)X_i \sim P(\lambda_i) \Rightarrow X_1 + X_2 + \dots + X_k \sim P(\lambda_1 + \dots + \lambda_k)
  • Xi∼N(μi,σi2)⇒a1X1+a2X2+⋯+akXk∼N(∑aiμi,∑ai2σi2)X_i \sim N(\mu_i, \sigma_i^2) \Rightarrow a_1 X_1 + a_2 X_2 + \dots + a_k X_k \sim N(\sum a_i \mu_i, \sum a_i^2 \sigma_i^2)
  • Xi∼χ2(ni)⇒X1+X2+⋯+Xk∼χ2(n1+n2+⋯+nk)X_i \sim \chi^2(n_i) \Rightarrow X_1 + X_2 + \dots + X_k \sim \chi^2(n_1 + n_2 + \dots + n_k)
  • Xi∼E(λ)⇒min⁡(X1,X2…Xk)∼E(λ1+λ2+⋯+λk)X_i \sim E(\lambda) \Rightarrow \min(X_1, X_2 \dots X_k) \sim E(\lambda_1 + \lambda_2 + \dots + \lambda_k)

数字特征 ​

  • 期望:性质:E(c)=cE(c) = c, E(cX)=cE(X)E(cX) = cE(X), E(X+c)=E(X)+cE(X+c) = E(X)+c, X,YX, Y 相互独立 E(XY)=E(X)E(Y)E(XY) = E(X)E(Y)
  • 方差:性质:Var(c)=0Var(c) = 0, Var(cX)=c2VarXVar(cX) = c^2 VarX, if X,YX, Y 相互独立 Var(X±Y)=VarX+VarYVar(X \pm Y) = VarX + VarY
  • 切比雪夫不等式: def:P(∣X−EX∣≥ε)≤VarXε2def: P(|X - EX| \ge \varepsilon) \le \frac{VarX}{\varepsilon^2}

协方差、相关系数、大数定律 ​

协方差 ​

def:Cov(XY)=E(XY)−EX⋅EYdef: Cov(XY) = E(XY) - EX \cdot EY

性质:

  1. Cov(X,X)=Cov(Y,Y)Cov(X, X) = Cov(Y, Y)
  2. Cov(X,c)=0Cov(X, c) = 0
  3. Cov(aX,bY)=abCov(X,Y)Cov(aX, bY) = ab Cov(X, Y)
  4. Cov(X±Y,Z)=Cov(X,Z)+Cov(Y,Z)Cov(X \pm Y, Z) = Cov(X, Z) + Cov(Y, Z)
    • ifif X,YX, Y 独立 Cov(X,Y)=0Cov(X, Y) = 0
  5. Var(X±Y)=VarX+VarY±2Cov(X,Y)Var(X \pm Y) = VarX + VarY \pm 2Cov(X, Y)
    • Cov(X,X)=VarXCov(X, X) = VarX

相关系数 ​

def:ρXY=Corr(X,Y)=Cov(X,Y)VarXVarYdef: \rho_{XY} = Corr(X, Y) = \frac{Cov(X, Y)}{\sqrt{VarX}\sqrt{VarY}}

  • if Corr(X,Y)=0Corr(X, Y) = 0 则 X,YX, Y 不相关

性质:

  1. ∣ρXY∣≤1|\rho_{XY}| \le 1, ρXX=ρYX\rho_{XX} = \rho_{YX}, ρXX=1\rho_{XX} = 1
  2. ∣ρXY∣=1  ⟺  P(Y=aX+b)=1|\rho_{XY}| = 1 \iff P(Y = aX+b) = 1
  3. ∣ρXY∣|\rho_{XY}| 越接近1,表明 X,YX, Y 的线性相关程度越大
    • 只有当 (X,Y)∼N(X, Y) \sim N,独立   ⟺  \iff 不相关

大数定律和中心极限定理 ​

大数定律 ​

def:lim⁡n→∞P(∣Xn−a∣≥ε)=0⇒Xn→Padef: \lim_{n \to \infty} P(|X_n - a| \ge \varepsilon) = 0 \Rightarrow X_n \xrightarrow{P} a (依概率收敛)

性质: Xn→PaX_n \xrightarrow{P} a, 则 g(Xn)→Pg(a)g(X_n) \xrightarrow{P} g(a) (g(x)g(x) 在 aa 处连续)

  1. 切比雪夫大数定律: X1…XnX_1 \dots X_n 两两不相关,且 VarXnVar X_n 一致有界。 Xˉ→PEXˉ\bar{X} \xrightarrow{P} E\bar{X}

    • lim⁡n→∞P(∣1n∑Xi−1n∑EXi∣<ε)=1\lim_{n \to \infty} P(|\frac{1}{n}\sum X_i - \frac{1}{n}\sum EX_i| < \varepsilon) = 1.
  2. (常用) 辛钦大数定律: 1∘X1…Xn1^\circ X_1 \dots X_n iid 2∘EXi=μ2^\circ EX_i = \mu 存在。

    • Xˉ→Pμ\bar{X} \xrightarrow{P} \mu, lim⁡n→∞P(∣1n∑Xi−μ∣<ε)=1\lim_{n \to \infty} P(|\frac{1}{n}\sum X_i - \mu| < \varepsilon) = 1
  3. 列维-林德伯格定理: X1…XnX_1 \dots X_n iid, EXk=μ,VarXk=σ2>0EX_k = \mu, Var X_k = \sigma^2 > 0

  • 即:∑Xi→近似N(nμ,nσ2)\sum X_i \xrightarrow{近似} N(n\mu, n\sigma^2)
  • ∑Xi−nμnσ=Xˉ−μσ/n→近似(0,1)\frac{\sum X_i - n\mu}{\sqrt{n}\sigma} = \frac{\bar{X} - \mu}{\sigma/\sqrt{n}} \xrightarrow{近似} (0, 1).
  1. 棣莫弗-拉普拉斯定理: Xn∼B(n,p)X_n \sim B(n, p), Xn→n→∞N(np,np(1−p))X_n \xrightarrow{n \to \infty} N(np, np(1-p))

抽样分布、Fisher定理 ​

常用统计量的数字特征 ​

1. 样本均值

X‾=1n∑i=1nXi;\overline{X} = \frac{1}{n}\sum_{i=1}^{n}X_i ;

2. 样本方差

S2=1n−1∑i=1n(Xi−X‾)2;S^2 = \frac{1}{n-1}\sum_{i=1}^{n}(X_i - \overline{X})^2 ;

  1. 样本标准差

S=1n−1∑i=1n(Xi−X‾)2;S = \sqrt{\frac{1}{n-1}\sum_{i=1}^{n}(X_i - \overline{X})^2} ;

5个常用结论

X1,X2,⋯ ,XnX_1, X_2, \cdots, X_n 为来自总体 XX 的样本,EX=μ,VarX=σ2EX = \mu, VarX = \sigma^2

  1. EXi=μ,VarXi=σ2EX_i = \mu, \quad VarX_i = \sigma^2;

  2. EX‾=μ,VarX‾=σ2nE\overline{X} = \mu, \quad Var\overline{X} = \frac{\sigma^2}{n};

  3. ES2=σ2ES^2 = \sigma^2 ,VarS2=2σ4n−1Var S^2=\frac{2\sigma^{4}}{n-1}

三大抽样分布 ​

  1. χ2\chi^2 分布: defdef: X1…XnX_1 \dots X_n 相互独立 N(0,1)N(0, 1),相互独立。则 χ2=X12+⋯+Xn2\chi^2 = X_1^2 + \dots + X_n^2
    • χ2∼χ2(n)\chi^2 \sim \chi^2(n)
    • Eχ2=nE\chi^2 = n, Varχ2=2nVar\chi^2 = 2n
    • 性质:可加性: χ12∼χ2(n1),χ22∼χ2(n2)\chi_1^2 \sim \chi^2(n_1), \chi_2^2 \sim \chi^2(n_2) 且独立,则 χ12+χ22∼χ2(n1+n2)\chi_1^2+\chi_2^2 \sim \chi^2(n_1+n_2)
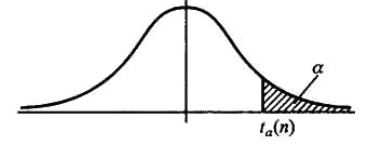
  2. t 分布: def:X∼N(0,1),Y∼χ2(n)def: X \sim N(0, 1), Y \sim \chi^2(n), X,YX, Y 独立。
    • t=XY/n∼t(n)t = \frac{X}{\sqrt{Y/n}} \sim t(n) (自由度为 nn 的 tt 分布)
    • 性质: tt 分布的概率密度是偶函数
  3. F 分布: def:X∼χ2(n1),Y∼χ2(n2)def: X \sim \chi^2(n_1), Y \sim \chi^2(n_2), X,YX, Y 独立
    • F=X/n1Y/n2∼F(n1,n2)F = \frac{X/n_1}{Y/n_2} \sim F(n_1, n_2)
    • 性质: 1)F∼F(n1,n2)⇒1F∼F(n2,n1)1) F \sim F(n_1, n_2) \Rightarrow \frac{1}{F} \sim F(n_2, n_1), 2)X∼t(n)⇒X2∼F(1,n)2) X \sim t(n) \Rightarrow X^2 \sim F(1, n).

正态总体抽样分布 ​

def:X1…Xndef: X_1 \dots X_n 来自 N(μ,σ2)N(\mu, \sigma^2),xˉ=1n∑Xi,S2=1n−1∑(Xi−xˉ)2\bar{x} = \frac{1}{n}\sum X_i, S^2 = \frac{1}{n-1}\sum (X_i - \bar{x})^2

  • 1):xˉ∼N(μ,σ2n)1): \bar{x} \sim N(\mu, \frac{\sigma^2}{n}), (xˉ−μ)n/σ∼N(0,1)(\bar{x} - \mu)\sqrt{n} / \sigma \sim N(0, 1)
  • 2):xˉ2): \bar{x} 与 S2S^2 相互独立
  • 3):(n−1)S2σ2=∑(Xi−xˉ)2σ2∼χ2(n−1)3): \frac{(n-1)S^2}{\sigma^2} = \frac{\sum (X_i - \bar{x})^2}{\sigma^2} \sim \chi^2(n-1); ∑(Xi−μ)2σ2∼χ2(n)\frac{\sum (X_i - \mu)^2}{\sigma^2} \sim \chi^2(n).
  • 4):T=xˉ−μS/n∼t(n−1)4): T = \frac{\bar{x} - \mu}{S/\sqrt{n}} \sim t(n-1)

参数估计 ​

点估计 ​

  • 矩估计法:1n∑Xik→PEXk\frac{1}{n} \sum X_i^k \xrightarrow{P} EX^k, 1n∑(Xi−xˉ)k→PE(X−EX)k\frac{1}{n}\sum (X_i - \bar{x})^k \xrightarrow{P} E(X - EX)^k
  • 最大似然估计:

  • 离散型总体 若总体 XX 的分布律为 P(X=x)=p(x;θ)P(X=x) = p(x; \theta),则似然函数为:

    L(θ)=∏i=1np(xi;θ)L(\theta) = \prod_{i=1}^{n} p(x_i; \theta)

  • 连续型总体 若总体 XX 的概率密度函数为 f(x;θ)f(x; \theta),则似然函数为:

    L(θ)=∏i=1nf(xi;θ)L(\theta) = \prod_{i=1}^{n} f(x_i; \theta)

  • 第一步:构造似然函数 写出样本的联合概率分布(或联合密度函数):

    L(θ)=∏i=1np(xi;θ)或∏i=1nf(xi;θ)L(\theta) = \prod_{i=1}^{n} p(x_i; \theta) \quad \text{或} \quad \prod_{i=1}^{n} f(x_i; \theta)

  • 第二步:取对数 为了简化计算(将连乘 ∏\prod 转化为求和 ∑\sum,方便求导),对 L(θ)L(\theta) 取自然对数:

    ln⁡L(θ)=∑i=1nln⁡p(xi;θ)或∑i=1nln⁡f(xi;θ)\ln L(\theta) = \sum_{i=1}^{n} \ln p(x_i; \theta) \quad \text{或} \quad \sum_{i=1}^{n} \ln f(x_i; \theta)

  • 第三步:建立似然方程并求解 对 θ\theta 求导,并令导数为 0(寻找驻点):

    d[ln⁡L(θ)]dθ=0\frac{d[\ln L(\theta)]}{d\theta} = 0

    解出的 θ^\hat{\theta} 即为最大似然估计值。

  • 似然函数单调的用次序统计量

估计量的评价标准 区间估计 ​

估计量的评价标准:

  1. 无偏性: E(θ^)=θ⇒E(\hat{\theta}) = \theta \Rightarrow 无偏估计
  2. 有效性: Varθ^1<Varθ^2Var \hat{\theta}_1 < Var \hat{\theta}_2,则 θ^1\hat{\theta}_1 更有效。
  3. 相合性: θ^→Pθ\hat{\theta} \xrightarrow{P} \theta

区间估计:枢轴量

待估参数已知条件枢轴量 & 分布置信区间 (1−α)(1-\alpha)
μ\muσ2\sigma^2 已知Xˉ−μσ/n∼N(0,1)\displaystyle \frac{\bar{X}-\mu}{\sigma/\sqrt{n}} \sim N(0,1)(xˉ−uα2σn,xˉ+uα2σn)\displaystyle \left( \bar{x} - u_{\frac{\alpha}{2}}\frac{\sigma}{\sqrt{n}}, \quad \bar{x} + u_{\frac{\alpha}{2}}\frac{\sigma}{\sqrt{n}} \right)
μ\muσ2\sigma^2 未知Xˉ−μS/n∼t(n−1)\displaystyle \frac{\bar{X}-\mu}{S/\sqrt{n}} \sim t(n-1)(xˉ−t1−α2(n−1)Sn,xˉ+t1−α2(n−1)Sn)\displaystyle \left( \bar{x} - t_{1-\frac{\alpha}{2}}(n-1)\frac{S}{\sqrt{n}}, \quad \bar{x} + t_{1-\frac{\alpha}{2}}(n-1)\frac{S}{\sqrt{n}} \right)
σ2\sigma^2μ\mu 已知∑i=1n(Xi−μ)2σ2∼χ2(n)\displaystyle \frac{\sum_{i=1}^n(X_i-\mu)^2}{\sigma^2} \sim \chi^2(n)(∑i=1n(Xi−μ)2χ1−α22(n),∑i=1n(Xi−μ)2χα22(n))\displaystyle \left( \frac{\sum_{i=1}^n(X_i-\mu)^2}{\chi^2_{1-\frac{\alpha}{2}}(n)}, \quad \frac{\sum_{i=1}^n(X_i-\mu)^2}{\chi^2_{\frac{\alpha}{2}}(n)} \right)
σ2\sigma^2μ\mu 未知(n−1)S2σ2∼χ2(n−1)\displaystyle \frac{(n-1)S^2}{\sigma^2} \sim \chi^2(n-1)((n−1)S2χ1−α22(n−1),(n−1)S2χα22(n−1))\displaystyle \left( \frac{(n-1)S^2}{\chi^2_{1-\frac{\alpha}{2}}(n-1)}, \quad \frac{(n-1)S^2}{\chi^2_{\frac{\alpha}{2}}(n-1)} \right)

算单侧的把α2\frac{\alpha}{2}换成换成α\alpha

次序统计量:

  • 最小值分布 (记为 X(1)X_{(1)} 或 min⁡\min):

    FX(1)(x)=1−{1−F(x)}nF_{X_{(1)}}(x) = 1 - \{1 - F(x)\}^n

  • 最大值分布 (记为 X(n)X_{(n)} 或 max⁡\max):

    FX(n)(x)=[F(x)]nF_{X_{(n)}}(x) = [F(x)]^n

海洋科学导论笔记
俄语二外笔记
广告位招租
我已经活了
20年10月2天23时11分25秒
本文阅读 - 次本站访问 - 次本站访客 - 人
由 Valaxy v1.1.0 驱动|主题-Yunv1.1.0